Marius POPA este fostul meu student cu care am derulat un stagiu doctoral finalizat prin susținerea cu succes, în anul 2005, a tezei de doctorat de 290 pagini, intitulată Tehnici și metode de evaluare a calității datelor.
În intervalul 1992 - 1996, Marius a fost elev la Liceul Mihail EMINESCU din Bârlad.
În intervalul 1997 - 2002 Marius POPA a urmat cursurile Secției de Informatică Economică din Facultatea de Cibernetică, Statistică și Informatică Economică și a susținut cu succes lucrarea de licență.
În intervalul 2002 - 2003 Marius POPA a urmat cursurile aprofundate organizate de Catedra de Informatică Economică și a susținut cu succes lucrarea de disertație.
În intervalul 2002 - 2005 Marius POPA a urmat stagiul doctoral în specializarea Cibernetică și Statistică Economică și a susținut cu succes teza de doctorat.
În martie 2024 Marius POPA a susținut cu succes teza de abilitare intitulată Using Security Analysis to Enhance Internet of Things Solutions and Security of Mobile and Embedded Platforms și în iunie 2024 a obținut atestatul de abilitare de la Ministerul Educației.
După terminarea studiilor de licență Marius POPA a lucrat în mediul academic după cum urmează:
în intervalul 2003 - 2005 a fost preparator universitar,
în intervalul 2005 - 2006 a fost asistent universitar,
în intervalul 2006 - 2013 a fost lector universitar,
în intervalul 2013 - 2024 a fost conferențiar universitar,
din 2024 este profesor universitar.
Am colaborat foarte eficient cu Marius POPA pentru că el este un cercetător științific deosebit, are o putere de muncă specială și dispune de calitățile necesare pentru a intra într-o echipă cu care, dacă sunt începute proiecte, acele proiecte sunt duse la bun sfârșit în cele mai bune condiții. Așa se explică faptul că am realizat împreună lucrări referite prin:
Ion IVAN, Marius POPA, Paul POCATILU (coordonatori) - Structuri de date, vol. 1 și vol. 2, Editura ASE, București, 2008. Vol. 1: Tipologii de structuri de date, 770 pag., ISBN 978-606-505-032-7. Vol. 2: Managementul structurilor de date, 534 pag., ISBN 978-606-505-033-4. Lucrarea a fost distinsă cu Premiul Academiei Române Tudor TĂNĂSESCU pe anul 2008.
Ion IVAN, Gheorghe NOȘCA, Sergiu CAPISIZU, Marius POPA - Managementul calității aplicațiilor informatice, Editura ASE, București, 2007, 500 pg, ISBN 10 973-594-843-5, ISBN-13 978-973-594-843-6
Ion IVAN, Gheorghe NOȘCA, Marius POPA - Managementul calității aplicațiilor informatice. Editura ASE, București, 2006.
Ion IVAN, Marius POPA - Entități text, dezvoltare, evaluare, analiză, Editura ASE, București, 2005, ISBN 973-594-663-7, 587 pg
Ion IVAN, Marius POPA, Sergiu CAPISIZU, Lukacs BREDA, Bogdan FLORESCU - Clonarea informatică, Editura ASE, București, 2003, 213 pg., ISBN 973-594-310-7.
Marius POPA, Alin ZAMFIROIU, Cristian CIUREA, Mihai DOINEA - Structuri de date. Teorie și practică, Editura ASE, București, 2023, 282 pag, ISBN: 978-606-340-438-2
Noi am scris și publicat împreună multe articole, am mers la diferite conferințe științifice cu comunicări apreciate de cei din sala unde au fost prezentate. Toate acestea arată că Marius este un cercetător științific valoros, care știe să deruleze toate etapele procesului de cercetare științifică cu un nivel de exigență special, care știe să facă analiză, să sintetizeze rezultatele, astfel încât să fie prezentate numai rezultatele valoroase, pe care specialiștii le vor aprecia.
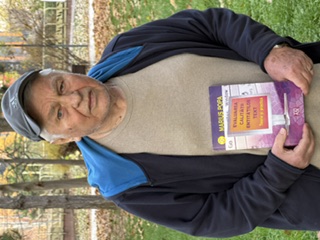
Am în mână cartea referită prin:
Marius POPA - Evaluarea calității entităților text. Teorie și practică, Editura ASE, București, 2005, 260 pag, ISBN: 973-594-712-9
 abc |
Cartea are 10 capitole după cum urmează:
Capitolul 01, de la paginile 1 - 11, intitulat Introducere, prezintă obiectivul urmărit de autor în realizarea lucrării și apoi prezintă pe scurt fiecare capitol. Se specifică faptul că a existat un contract de cercetare 148.29.09.2004 în cadrul INFOSOC, dedicat analizei entităților text.
Capitolul 02, de la paginile 13 - 47, intitulat Caracteristicile de calitate ale textelor, prezintă conceptele de alfabet, caracter, cuvânt, vocabular, text, text structurat, tipuri de entități structurate, figurile 2.5 - 2.14, precum și clasele de structură, grupate după complexitate, dar și după alte criterii. Tot aici sunt analizate caracteristicile de calitate a datelor precum consistența, completitudinea, uniformitatea, fiabilitatea și sunt propuși indicatori pentru măsurarea lor. Subcapitolul 2.7 este dedicat îmbunătățirii calității datelor, unde autorul valorifică experiența acumulată în operarea pe entități text complexe.
Capitolul 03, de la paginile 48 - 77, intitulat Caracteristicile de calitate ale entităților text, prezintă o serie de indicatori asociați caracteristicilor de calitate a entităților text. Se definește lungimea cuvântului, lungimea textului ca număr de caractere sau ca număr de cuvinte. Se prezintă și indicatori sintetici. Este asociată o mulțime de indicatori caracteristicii de calitate numită corectitudinea textului. Autorul asociază expresii analitice pentru completitudine și pentru fiabilitate, ținând seama de particularitățile pe care le prezintă textele. La paginile 65 - 70 sunt prezentate entități text cu niveluri diferite de complexitate, exprimate ca numere ciclomatice. La pagina 73 este definit indicatorul grad de omogenitate al entității text. Abordările de la următoarele pagini evidențiază operaționalitatea indicatorilor definiți, chiar dacă nivelul de complexitate al expresiilor analitice asociate lor este ceva mai ridicat.
Capitolul 04, de la paginile 78 - 111, intitulat Ortogonalitatea textelor, definește conceptul de ortogonalitate a două sau mai multe entități text. Se introduce conceptul de clonare informațională. Aici arăt că în anii precedenți subiectul clonării a fost abordat distinct, în lucrarea referită prin:
Ion IVAN, Marius POPA, Sergiu CAPISIZU, Lukacs BREDA, Bogdan FLORESCU - Clonarea informatică, Editura ASE, București, 2003, 213 pg., ISBN 973-594-310-7.
Aici totul este prezentat sub alt unghi și anume în unghiul măsurării ortogonalității entităților text. Indicatorii de la paginile 88 - 101 sunt ușor de implementat de către programatori, iar exemplele date de Marius POPA permit verificarea modului de implementare.
Capitolul 05, de la paginile 112 - 138, intitulat Proprietățile metricilor entităților text, este un capitol interesant prin faptul că analizează completitudinea, stabilitatea, continuitatea, generalitatea, agregarea metricilor, folosind exemple reprezentative. Sunt analizați indicatorii prin prisma proprietăților lor de senzitivitate, necatastroficitate și caracter necompensatoriu, paginile 133 - 138, considerațiile fiind concentrate foarte mult dacă ne gândim la diversitatea și la complexitatea expresiilor analitice.
Capitolul 06, de la paginile 139 - 159, intitulat Validarea metricilor textelor, are o abordare realistă a problemei, având în vedere complexitatea unei metrici și caracterul relativ al procesului de validare. Am apreciat că autorul lucrării a sintetizat la liniuță tot ceea ce ar fi necesitat multe pagini de text, pentru a pune la dispoziția cititorului câteva idei, pentru ca acesta din urmă să aibă libertatea să-și definească propriile procese de validare, conform exigențelor lui. Un rol aparte este acordat validării structurale a metricilor entităților text. Sunt date expresii analitice, dar cititorul trebuie să se gândească la faptul că indicatorii sunt niște convenții, deci el însuși își poate defini indicatori proprii pe care să-i valideze dacă îi reunește într-o metrică.
Capitolul 07, de la paginile 160 - 178, intitulat Cerințe ale implementării metricilor, pornește de la faptul că datele sunt generate, iar calitatea datelor este esențială. Trebuie acceptată ideea existenței costului datelor, iar modelele liniare de la paginile 171 și 172 sunt edificatoare, ca și dezvoltările de la paginile următoare.
|
abc 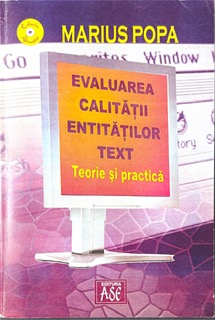 abc |
Capitolul 09, de la paginile 208 - 223, intitulat Procese de inginerie și reinginerie a entităților text, arată că și o entitate text are dinamica ei, iar ingineria, respectiv reingineria sunt procese de șlefuire a unei entități care parcurge versiuni până la a ajunge la versiunea finală. Autorul arată când este momentul optim de declanșare a procesului de reinginerie. Capitolul este interesant mai ales pentru cei care doresc să scrie articole de calitate. Unele edituri scriu cărți care îi învață pe oameni să scrie cărți, să scrie articole. Eu nu militez să extindem această abordare și în zona creației literare, căci nici Marius POPA nu o face. Sunt luate în considerare procese de reinginerie a entităților cu structuri omogene. Dacă o culegere de probleme este o astfel de entitate sau un program, cititorul va învăța cum trebuie să procedeze din start ca entitatea sa să poată fi supusă unui proces de reinginerie fără costuri covârșitoare.
Capitolul 10, de la paginile 224 - 228, intitulat Concluzii, unde se arată că entitățile text sunt dezvoltate și analizate nu oricum, ci doar după derularea unor procese pregătitoare, iar mijloacele și instrumentele utilizate trebuie să fie adecvate, cunoscute și tratate corespunzător. Seturile de date trebuie să fie reprezentative, iar rezultatele să fie preluate dacă și numai dacă sunt reprezentative.
Lucrarea are două anexe, și anume:
Anexa 1 - Listă de variabile dispuse în ordine alfabetică.
Anexa 2 - Listă de acronime dispuse în ordine alfabetică.
Aceste anexe sunt instrumente utile cititorului pentru a urmări unele detalii din lucrare.
Când am primit cartea aceasta cu dedicație de la Marius POPA, după ce am citit-o, m-am convins că acesta este un cercetător științific format, care știe să deruleze un ciclu complet de cercetare științifică, iar calitatea soluțiilor originale obținute este certă, căci Marius POPA este un om exigent, care știe să analizeze și să ierarhizeze corect acele soluții.
Am în mână cartea referită prin:
De domeniul structurilor de date m-am ocupat de mulți ani, fără a spune că am fost dat afară de la grădiniță că m-am lăudat cu așa ceva. Am publicat materiale de structuri de date în anii 2008, 2005, 2003, 1998, 1992.
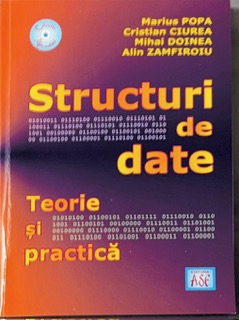
Azi, 05 mai 2023, mai tânărul meu coleg Marius POPA mi-a oferit un exemplar din lucrarea referită prin:
Marius POPA, Cristian CIUREA, Mihai DOINEA, Alin ZAMFIROIU - Structuri de date, Teorie și practică, Editura ASE, București, 2023, 280 pag., ISBN 978-606-34-0438-2
 abc |
Lista figurilor
Lista tabelelor
Cuvânt înainte
Introducere
Reprezentarea internă a datelor
Masive de date
Structuri dinamice liniare înlănțuite
Tabela de dispersie
Structura coadă de priorități
Structuri arborescente
Structura de tip graf
Concluzii
Bibliografie.
Întrucât cuvântul înainte l-am scris eu, îl voi reproduce aici.
Am așteptat cu deosebit interes demersul întreprins de prof. dr. Cristian CIUREA, conf. dr. Mihai DOINEA, conf. dr. Marius POPA și conf. dr. Alin ZAMFIROIU, cadre didactice prestigioase la Departamentul de Informatică și Cibernetică Economică, de a trimite spre publicare la Editura ASE lucrarea intitulată Structuri de date, teorie și practică. Lucrarea este rodul unei îndelungate activități desfășurate de cei patru autori la Facultatea de Cibernetică, Statistică și Informatică Economică, Secția Informatică Economică, unde ei au predat cursuri și au coordonat activități de laborator la disciplina Structuri de date, aflată în programa de învățământ a studenților, viitori informaticieni.
Autorii au structurat lucrarea pe capitole care urmăresc o abordare graduală a problematicii structurilor de date, îmbinând latura teoretică cu latura practică, pentru a oferi studenților, dar și specialiștilor din producție, un suport solid care să le permită derularea unor procese optime de alocare și nivelare de resurse, atunci când trec la dezvoltarea de aplicații informatice cu nivel de complexitate ridicat, destinate unui număr foarte ridicat de utilizatori în mediul online mai ales.
În capitolul intitulat Reprezentarea internă a datelor, autorii, foarte buni cunoscători ai limbajului de asamblare, prezintă o serie de detalii absolut necesare înțelegerii reprezentării datelor în memorie, a modurilor de adresare, a mecanismelor de alocare și de gestionare dinamică a zonelor de memorie. Un spațiu important din acest capitol este rezervat variabilelor pointer, iar exemplificările sunt efectuate folosind limbajul de programare C.
Capitolul intitulat Masive este destinat prezentării structurilor de date omogene vector și matrice. Modul de alocare a zonelor de memorie și referirea elementelor sunt puse în evidență prin utilizarea unei aplicații complexe, cu multe funcții de prelucrare. Alegerea acestui mod de abordare permite trecerea rapidă spre soluționarea de probleme dintr-o clasă foarte cuprinzătoare, căci colectivităților omogene din viața reală le corespund în plan informatic aplicații în care lucrul cu vectorii și cu matricele sunt cele mai potrivite.
Pentru a prezenta listele simplu înlănțuite și listele dublu înlănțuite, a fost construit capitolul Structuri de date liniare înlănțuite. Sunt prezentate conceptele de bază și operațiile cu aceste structuri de date dinamice. Fiecărei operații îi corespunde o funcție scrisă în limbajul C. Aici sunt prezentate operațiile de creare element, de numărare elemente, de sortare a elementelor, de inserare element, de ștergere element, de ștergere a întregii liste, de concatenare a două liste și de descompunere a unei liste în două liste. Construcția funcțiilor permite preluarea textelor de către orice dezvoltator, cu efectuarea rapidă a adaptărilor care să permită implementarea listelor simple în textele lor sursă. În același mod se procedează și în cazul listelor dublu înlănțuite. Sunt date criterii de selecție care arată când trebuie implementate listele simplu înlănțuite și când se implementează listele dublu înlănțuite în aplicații informatice, căci diferențele dintre ele generează performanță numai când alegerea este adecvată.
Capitolul intitulat Tabele de dispersie conține tratarea unei structuri de date extrem de utile în aplicațiile unde se impun regăsiri de informații după chei. Sunt date operații de inserare, de căutare, de vizualizare și de ștergere. Sunt prezentate diferite variante de creare a tabelelor de dispersie, cu avantajele și limitele pe care acestea le prezintă. Pentru structura Coadă de priorități autorii au construit un capitol special în care sunt prezentate funcții de inserare element cu prioritate dată, afișare elemente, identificarea elementului disponibil, schimbarea priorității, extragerea elementului cu prioritate maximă și verificarea conținutului structurii. Textul sursă propus de autori se translatează rapid către problemele dezvoltatorilor în care ierarhizarea elementelor din colectivități se realizează în baza unor priorități stabilite după reguli clar definite.
Structuri arborescente este capitolul în care sunt prezentați arborii oarecare, arborii binari, arborii binari de căutare, arborii echilibrați, arborii AVL și arborii de structură. Pentru fiecare tipologie de arbori sunt prezentate funcții corespunzătoare operațiilor de creare, de traversare, de inserare nod, de ștergere nod, de afișare nod, calcul înălțime arbore. Și aici s-a optat pentru ideea de a exemplifica utilizarea fiecărei structuri arborescente pentru câte o clasă de probleme care este reprezentativă și care se regăsește frecvent în practica dezvoltatorilor de software.
Pentru grafuri este dedicat un capitol distinct și sunt dezvoltate atât abordări privind matricele de adiacență, cât și abordări cu alocare dinamică a memoriei pentru nodurile unui graf. Sunt detaliate funcțiile de traversare în graf în înălțime, de căutare, de alocare, de dezalocare, de inserare arce, de inserare noduri. Sunt implementați algoritmi de stabilire a drumului minim și de stabilire a costului minim în graful definit într-o matrice. Dezvoltatorii de software care parcurg acest capitol au posibilitatea de a soluționa direct, folosind funcțiile date, variante de probleme de transport cu identificarea de rute eficiente după diferite criterii combinate, prin introducerea de filtre proprii.
Lucrarea se încheie cu Concluzii, parte care sintetizează elocvent necesitatea utilizării adecvate a structurilor de date, căci diferența între o structură de date adecvat folosită și una folosită la întâmplare se concretizează prin creșterea semnificativă a performanței aplicației informatice, mai ales prin reducerea drastică a timpilor de prelucrare, mai exact a timpilor de așteptare ai utilizatorilor care folosesc cu deosebire aplicații online.
Bibliografia folosită de autori include lucrări publicate majoritatea în ultimii ani, lucrări reprezentative din domeniu, selectate cu grijă, lucrări care sunt accesibile în mediul online.
Textele sursă incluse în lucrare sunt reprezentative pentru clase de probleme frecvent întâlnite în viața de toate zilele. Textele sursă sunt autodocumentate folosind comentarii sugestive. S-a optat pentru creșterea clarității textelor sursă prin alegerea numelor de identificatori folosind cuvinte sugestive legate prin underscore. Secvențele de instrucțiuni ce se referă la o anumită prelucrare sunt grupate în blocuri distincte, ușor de urmărit căci delimitatorii de bloc se află pe linii sursă separate. Toate programele scrise și incluse în carte au fost verificate, testate și validate, astfel încât, prin utilizarea directă, studenții și dezvoltatorii de software au un punct de plecare sigur, care să le asigure succesul necesar în elaborarea de texte sursă pentru propriile probleme.
Lucrarea a fost gândită pentru a fi utilă celor care doresc să scrie software performant, cu nivel de complexitate ridicat și care urmăresc obținerea unui nivel ridicat de calitate prin includerea de secvențe de instrucțiuni verificate de-a lungul timpului, bine gândite, optimale, dacă prin acest concept se acceptă secvențele cele mai bune dintr-o multitudine cunoscută de secvențe de instrucțiuni și nu din totalitatea de secvențe care ar exista vreodată.
|
abc  abc |
Autorii acestei lucrări originale sunt doctori în specializarea Informatică Economică, au o vastă experiență atât didactică, cât și de cercetare științifică. Dr. Cristian CIUREA dezvoltă proiecte de informatică la Biblioteca Academiei Române, dr. Mihai DOINEA și dr. Marius POPA dezvoltă proiecte de informatică la compania ORACLE, iar dr. Alin ZAMFIROIU dezvoltă proiecte de informatică la Institutul de Cercetări în Informatică.
Este o onoare pentru mine să scriu aceste rânduri, căci am urmărit evoluția celor patru autori de-a lungul timpului și această lucrare este una din șirul lung al realizărilor pe care le-au concretizat prin colaborare rodnică, prin muncă asiduă și dovedind exigență, rigurozitate și originalitate în toate demersurile lor.
Îmi exprim credința că lucrarea Structuri de date, teorie și practică, scrisă de dr. Cristian CIUREA, dr. Mihai DOINEA, dr. Marius POPA și dr. Alin ZAMFIROIU, va fi o lucrare de referință în domeniu, iar studenții și specialiștii informaticieni vor avea un instrument deosebit de util în munca lor pentru a crește calitatea și eficiența aplicațiilor informatice pe care le vor realiza după studierea ei, dar mai ales după ce vor translata în textele lor sursă secvențe cu care autorii exemplifică avantajele folosirii anumitor structuri de date, integrate în construcțiile proprii.
M-am bucurat să văd că cei patru tineri duc mai departe tradiția care a fost dezvoltată începând cu anul universitar 1991 - 1992 la Secția de Informatică Economică, și structurile de date au rămas o disciplină deosebit de importantă pentru studenții care vor să devină specialiști de înaltă clasă, căci totul depinde de cum ei vor ști să aleagă structurile de date adecvate atunci când vor dezvolta aplicații informatice în viitor. Să nu uite nimeni că fișierul este o structură de date, că baza de date este o structură de date, că obiectele sunt structuri de date, că inteligența artificială se bazează pe operații complexe cu structuri de date și că orice dezvoltare viitoare a tehnologiilor informatice nu se va realiza în afara structurilor de date.
(01 octombrie 2026, Mahalaua Vitanului)